Verarbeitung nur in der EU
Die Plattform wird in Deutschland betrieben. Texterkennung und Extraktion laufen auf KI-Modellen in Rechenzentren innerhalb der EU. Deine Dokumente werden nicht in Drittländer übermittelt, auch nicht in die USA.
Für Dokumente, die Diskretion verdienen
OCR und strukturierte Datenextraktion für deine Software: Verträge, Belege und Akten werden lesbar, durchsuchbar und auswertbar. Verarbeitet wird ausschließlich in der EU, mit klaren Löschfristen und ohne Modelltraining.
Für Kanzleien, Steuerberatungen und Praxen – und für die Teams, die deren Software entwickeln.
NeuCapture: Dokumente per Handykamera ins FormularRechnung
EX-2026-0142
Musterbüro · Berlin
01 / Vertraulichkeit
Sensible Informationen brauchen mehr als präzise Texterkennung. Entscheidend ist, wo sie verarbeitet werden, wofür sie genutzt werden und wann sie wieder gelöscht werden.
Die Plattform wird in Deutschland betrieben. Texterkennung und Extraktion laufen auf KI-Modellen in Rechenzentren innerhalb der EU. Deine Dokumente werden nicht in Drittländer übermittelt, auch nicht in die USA.
Hochgeladene Dateien werden direkt nach der Verarbeitung gelöscht, Ergebnisse nach einer kurzen Abruffrist. Deep-OCR ist kein Dokumentenarchiv.
Deine Dokumente und Extraktionsergebnisse werden nicht zum Training oder zur Verbesserung von KI-Modellen verwendet.
Auftragsverarbeitungsvertrag nach Art. 28 DSGVO, Übersicht der technischen und organisatorischen Maßnahmen und Verschwiegenheitsverpflichtung nach § 203 StGB – auch gegenüber unseren Subunternehmern.
02 / Anwendungsfälle
Große Dokumentenmengen, vertraulich verarbeitet – als einmaliges Projekt oder im laufenden Betrieb.
Regionale Versicherung · rund 15.000 Seiten pro Monat · laufender Betrieb
Bei einem regionalen Versicherer mit rund 300 Mitarbeitenden gehen jeden Tag Briefe, Rechnungen und Gutachten ein, die dem richtigen Vorgang zugeordnet werden müssen. Bisher wurde jede Seite von Hand gesichtet und verteilt. Das kostete fast 20 Stunden pro Woche, und die sensiblen Daten durften dabei die EU nicht verlassen. Heute liest Deep-OCR Absender, Datum und Aktenzeichen automatisch aus und leitet jedes Dokument direkt an den zuständigen Sachbearbeiter weiter, vollständig in der EU. Das Team gewinnt so fast zwei Arbeitstage pro Woche zurück.
Hausverwaltung · 400.000 Seiten · einmaliges Projekt
Eine Hausverwaltung wollte auf ein neues Dokumentenmanagementsystem umsteigen. Ihre Mietverträge und Abrechnungen aus mehreren Jahrzehnten lagen allerdings nur als Scan vor, ohne durchsuchbaren Text und ohne strukturierte Daten. Alles von Hand zu erfassen hätte über ein Jahr gedauert und den Umstieg blockiert. Deep-OCR hat den gesamten Bestand in drei Wochen verarbeitet und Mieter, Objekt und Vertragsbeginn direkt an das neue System übergeben. Heute findet das Team jedes Dokument in Sekunden.
Wirtschaftskanzlei · rund 2.500 Verträge · einmaliges Projekt
Eine Wirtschaftskanzlei begleitete einen Unternehmenskauf. Im Datenraum lagen rund 2.500 Verträge, viele davon alte Scans mit Stempeln, handschriftlichen Ergänzungen und Passagen auf Englisch. Für das Team ging es um die entscheidenden Fragen: Wo gibt es Change-of-Control-Klauseln, welche Kündigungsfristen laufen, wo liegen Haftungsrisiken? Manuell hätte die erste Durchsicht vier Associates rund drei Wochen gebunden. Deep-OCR hat alle Verträge lesbar gemacht, Parteien, Laufzeiten und relevante Klauseln strukturiert ausgelesen und personenbezogene Daten vor der weiteren Auswertung anonymisiert. Die Anwälte konnten sich nach zwei Tagen auf die kritischen Fälle konzentrieren, statt Seiten zu sortieren.
03 / CaptureNEU
Ein Snippet auf deiner Website, ein Button in deinem Formular. Am Laptop erscheint ein QR-Code, am Handy startet die Kamera direkt. Deine Kunden fotografieren Fahrzeugschein, Ausweis oder Beleg, und die Felder füllen sich von selbst. Ohne App, ohne Abtippen.
Kostenlos testen. Live auf deiner Website als Zusatzmodul, auf Anfrage.
04 / Preise
Teste die Extraktion mit eigenen Beispieldokumenten und wähle dann den Tarif, der zu deinem Volumen passt.
Alle Tarife enthalten den vollen API-Zugang. Alle Preise zzgl. gesetzlicher MwSt.
05 / Branchen
Für Berufsgeheimnisträger und alle Unternehmen, die mit vertraulichen Unterlagen arbeiten – integriert in die Software, die du ohnehin nutzt.
Recht & Beratung
Vertragsparteien, Fristen und Laufzeiten automatisch aus Verträgen auslesen. Gescannte Akten als durchsuchbaren Volltext in deine Systeme übernehmen.
Verträge · Akten · SchriftverkehrOCR für KanzleienSteuern & Buchhaltung
Rechnungen, Belege und Kontoauszüge automatisch in strukturierte Daten für deine Buchhaltung und deine Dokumentenprozesse überführen.
Rechnungen · Belege · KontoauszügeOCR für SteuerberaterGesundheitswesen
Arztbriefe, Befunde, Entlassberichte und Überweisungen nutzbar machen: als durchsuchbaren Volltext für die Patientenakte oder als strukturierte Felder wie Diagnose, Datum und behandelnde Einrichtung für deine Praxis- oder Kliniksoftware.
Arztbriefe · Befunde · Entlassberichte · AbrechnungOCR für Arztpraxen06 / Der Weg deiner Daten
Deine Dokumente werden nur vorübergehend verarbeitet, mit einem festen Zeitfenster für den Abruf. So sieht der Weg von der Übermittlung bis zur Löschung aus.
Du sendest das Dokument über die API. Die Datei wird verschlüsselt zwischengespeichert.
Deep-OCR extrahiert strukturierte Felder oder den Volltext. Direkt danach wird die Datei gelöscht.
Du rufst das Ergebnis innerhalb einer Stunde ab und übernimmst es in deinen Prozess.
Nach Ablauf der Abruffrist wird auch das Ergebnis gelöscht. Deep-OCR ist kein Dokumentenarchiv.
Für Konto- und Abrechnungsdaten gelten eigene Aufbewahrungsfristen. Zur Datenschutzerklärung
Anonymisierung und Schwärzung
Sehr geehrte Frau Musterfrau,
zu Ihrem Vorgang AZ 2026/0142 vom 12. März 2026 übersenden wir die angeforderten Unterlagen. Rückfragen richten Sie bitte an m.musterfrau@example.org.
Deep-OCR erkennt personenbezogene Daten wie Namen, Adressen, Geburtsdaten und Aktenzeichen und entfernt oder schwärzt sie vor der Weitergabe. Nachgelagerte Systeme, Auswertungen und KI-Assistenten erhalten so nur, was sie wirklich brauchen.
Welche Felder entfernt, pseudonymisiert oder beibehalten werden, legen wir gemeinsam für deinen Prozess fest. So bleibt das Berufsgeheimnis gewahrt, und du behältst trotzdem alle Informationen, die du für deine Arbeit brauchst.
07 / Integration
Dokument senden, Status abfragen, Ergebnis in deiner Anwendung weiterverwenden. Als strukturiertes JSON mit definierten Feldern oder als Markdown mit dem Volltext, auf Wunsch mit der Position jedes Worts und jeder Zeile auf der Seite: um Treffer zu markieren, Passagen zu schwärzen oder mit dem Original abzugleichen.
Dokument übermitteln
POST /v1/extractionsfile + document_type → 202 + idStatus abfragen, bis die Verarbeitung abgeschlossen ist
GET /v1/extractions/{id}queued → processing → completed / faileddocument_type=fulltext&include_coordinates=true→ markdown + layout: Wörter und Zeilen mit Boxen (0–1 der Seite)Gut zu wissen
Ja. Für Texterkennung und Extraktion setzen wir KI-Modelle ein. Die Plattform selbst wird in Deutschland betrieben, die Modelle laufen in Rechenzentren innerhalb der EU. Deine Dokumente werden nicht in Drittländer übermittelt, auch nicht in die USA, und nicht zum Training von Modellen verwendet. Die beteiligten Auftragsverarbeiter sind in unserem AVV aufgeführt und ebenso zur Verschwiegenheit verpflichtet.
Nein. Deep-OCR ist eine Schnittstelle (API), die in bestehende Software und Arbeitsabläufe eingebunden wird. Die Anbindung übernimmt dein Entwicklungsteam oder dein Softwarepartner. Im Kundenportal kannst du die Extraktion vorab mit Beispieldokumenten ausprobieren.
Hochgeladene Dateien werden verschlüsselt zwischengespeichert und direkt nach der Verarbeitung gelöscht. Das Ergebnis, ob erfolgreich oder fehlgeschlagen, bleibt eine Stunde lang abrufbar und wird danach ebenfalls gelöscht. Spätestens eine Stunde nach dem Upload wird die Datei auch dann gelöscht, wenn die Verarbeitung nicht abgeschlossen ist. Für Konto- und Abrechnungsdaten gelten eigene Aufbewahrungsfristen, siehe Datenschutzerklärung.
Ja. Deep-OCR erkennt personenbezogene Daten wie Namen, Adressen, Geburtsdaten und Aktenzeichen und kann sie vor der Weitergabe entfernen, pseudonymisieren oder schwärzen. Welche Felder das betrifft, legen wir gemeinsam für deinen Prozess fest. Denn allein das Entfernen von Namen macht ein Dokument noch nicht anonym.
Wir stellen dir einen Auftragsverarbeitungsvertrag nach Art. 28 DSGVO, eine Übersicht der technischen und organisatorischen Maßnahmen sowie eine Verschwiegenheitsverpflichtung nach § 203 StGB bereit. Dieselbe Verpflichtung besteht gegenüber unseren Subunternehmern, sodass die Verschwiegenheitskette geschlossen bleibt. Fordere die Unterlagen einfach an, wir senden sie dir zur Prüfung zu.
Deep-OCR verarbeitet PDFs, Bilder und gängige Office-Dokumente wie DOCX. Für unterstützte Dokumenttypen wie Rechnungen, Verträge oder Kontoauszüge liefern wir strukturiertes JSON, für alle anderen Dokumente den Volltext als Markdown, auf Wunsch mit der Position jedes Worts und jeder Zeile auf der Seite. Formate, Grenzen und Abrechnung beschreibt die API-Dokumentation.
Mit Capture bindest du ein Script-Tag auf deiner Website ein und setzt einen Button in dein Formular. Am Laptop zeigt der Button einen QR-Code, am Handy startet die Kamera direkt; eine App ist nicht nötig. Die Fotos gehen vom Handy direkt an Deep-OCR, werden nur in der EU verarbeitet und nach dem Auslesen gelöscht. Die ausgelesenen Werte landen in den Feldern deines Formulars.
Über uns
Kanzleien, Steuerberatungen und Arztpraxen wollen ihre Dokumente mit KI verarbeiten. Oft bleibt es dabei, weil unklar ist, wo die Daten landen, wer sie sieht und wie lange sie gespeichert werden. Deep-OCR gibt es, damit diese Fragen eine klare Antwort haben.
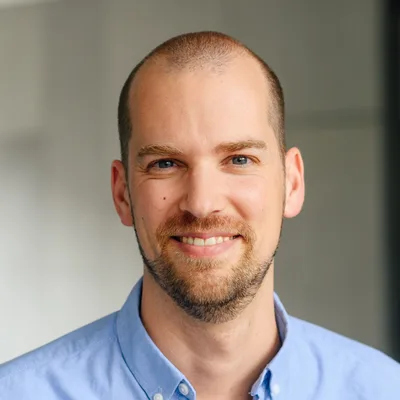
Gründer von Heey und Gini
Holger hat Gini mitgegründet, das Unternehmen hinter der Fotoüberweisung in vielen deutschen Banking-Apps. Gini zählt mehr als 7 Millionen monatlich aktive Nutzer und hat 2025 insgesamt 195 Millionen Dokumente verarbeitet. Beim Aufbau von Gini hat Holger Erfahrung mit zuverlässiger Dokumentenerkennung, Datenschutz und der Einbindung in Banken- und Versicherungssysteme gesammelt. Diese Erfahrung bringt er in Deep-OCR ein. Entwickelt und betrieben wird Deep-OCR von der Heey GmbH aus Gauting bei München.
Mehr über HeeySprechen wir über deine Dokumente
Wir schauen uns gemeinsam mit dir an, welche Dokumente du verarbeitest, wie die Integration aussieht und welche Anforderungen an den Datenschutz gelten.